Metric指标监控实战指南
时间:2026/10/31 14:41:32阅读:次
说到 Metric 指标监控,很多人第一反应就是装个工具、拉几块面板完事,真上手才发现坑一堆。我自己前前后后折腾过好几套监控方案,从最开始只会看 CPU 内存,到后来能按业务拆 Metric、配告警、做容量预估,中间踩的雷真不少。这篇就把 Metric 指标监控实战里那些实在的经验捋一遍,不管你是运维、开发还是刚接手监控的新人,看完至少能少走点弯路。
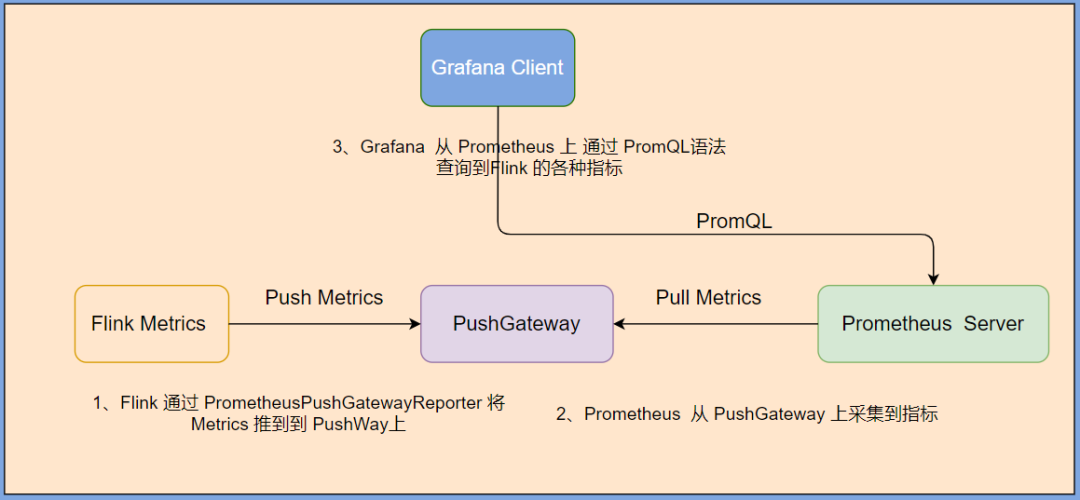
先想清楚要盯哪些 Metric,别一上来就堆工具
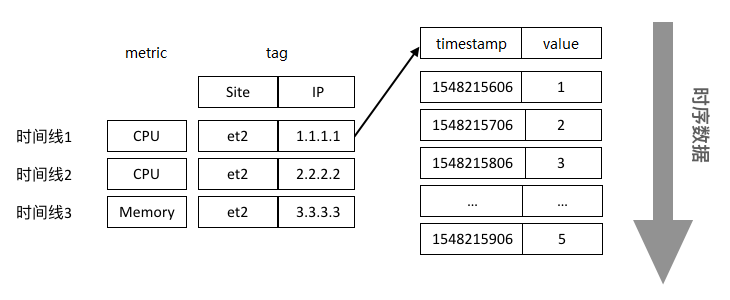
我见过太多人第一步就走偏,工具装了一堆,Metric 收了几千个,结果真出问题的时候没人看得懂面板。实话讲,监控这事得从业务往回推。先问自己:这个服务挂了,用户会感知到什么?是下单变慢,还是页面打不开?把这些转换成可量化的 Metric,比如请求延迟、错误率、队列积压量,才是真正该盯的。基础的主机指标像 CPU、内存、磁盘 IO 当然要有,但那只是底座,别把它当全部。我的习惯是每个核心服务先定三到五个关键 Metric,跑一段时间再补,贪多嚼不烂。还有个细节,Metric 的命名一定提前规划好,带上服务名和维度标签,不然后面查数据全靠猜,痛苦得很。
采集和存储这块,选型别只看名气
采集环节的坑主要集中在两点:频率和开销。采集太密,机器扛不住;太稀,尖刺全漏掉。一般业务指标 15 到 30 秒一次够用,核心链路可以压到 10 秒。存储方面,Metric 指标监控常用的时序库各有脾气,选之前先估算数据量和保留周期,别等磁盘爆了才后悔。我早期图省事直接往关系库里塞 Metric,量一上来查询慢得离谱,后来换成时序数据库才消停。另外标签别乱打,高基数标签是性能杀手,用户 ID 这种千万别往 Metric 标签里塞。
看板和告警,才是 Metric 真正干活的地方
面板不是越多越好,我现在的做法是一个服务一块主看板,从上到下按“入口流量、错误率、延迟、资源”排,出问题一眼能定位到哪层。告警更是重灾区,刚开始我把阈值调得特别敏感,结果一天几百条通知,最后大家都麻木了,真故障反而被淹了。后来改成只对用户可感知的 Metric 告警,再加个持续时长条件,误报立刻少一大半。还有告警要带上下文,光说“错误率高”没用,得附上当前值和对比曲线,值班的人才能快速判断。这套 Metric 指标监控流程跑顺之后,排障时间确实肉眼可见地缩短了。
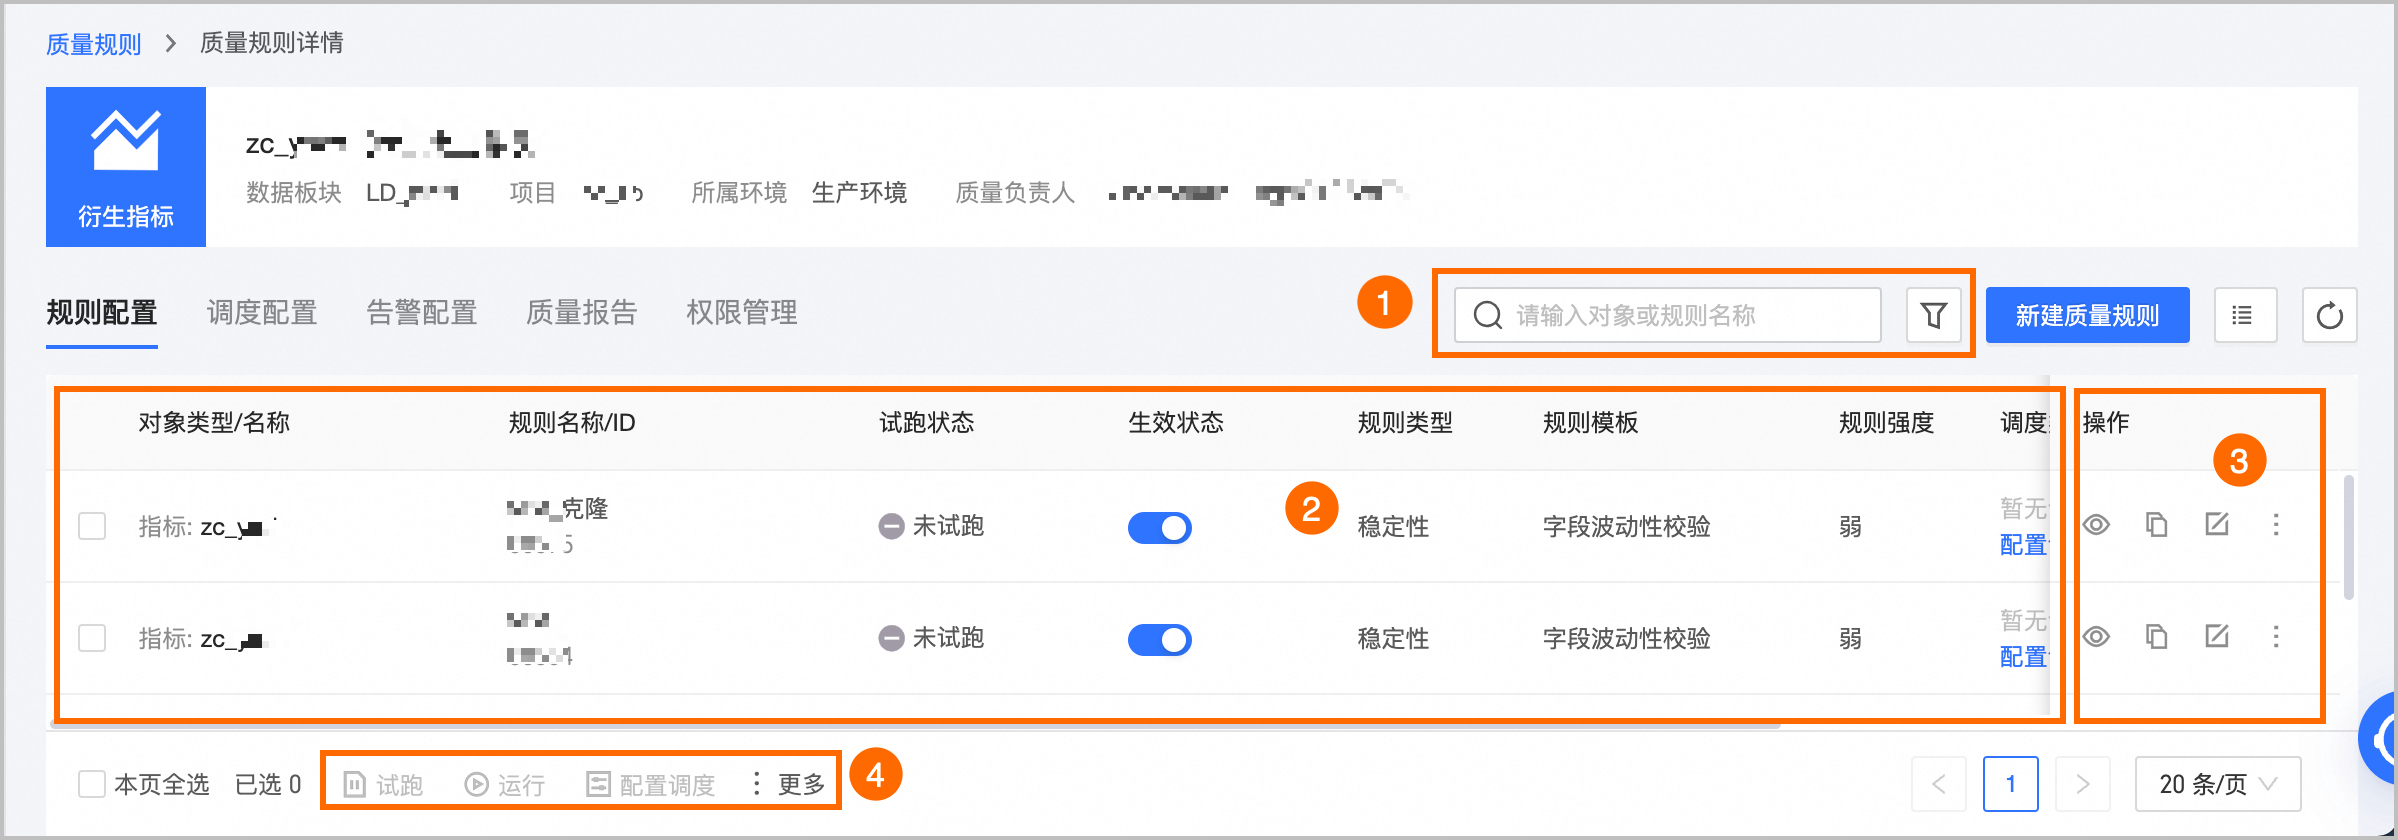
最后说句实在的,Metric 监控没有一步到位的方案,都是边跑边调。先把关键指标盯住,把告警噪音压下去,再慢慢补维度、做趋势分析。别追求大而全,能让你在出事前收到提醒、出事时快速定位,这套 Metric 监控就算合格了。
- 1
 雄安新区2025最新建设进展与未来发展规划
2026-10-30
- 2
美职篮全明星首发名单公布看点解析
- 3
美职篮全明星首发名单出炉谁入选了
- 4
托卡世界1.26.1万圣节免费更新版全解锁
- 5
冰城+冬季旅游攻略必去景点推荐
- 6
饿了么商家版app官方下载安装最新版
- 7
匿名信曝光内幕引发全网热议真相追踪
- 8
7M足球实时比分即时更新不错过任何进球
- 9
绝区零2026最新版下载安装教程一步到位
- 10
PUBG国际服最新安装包obb文件下载教程


热门评论